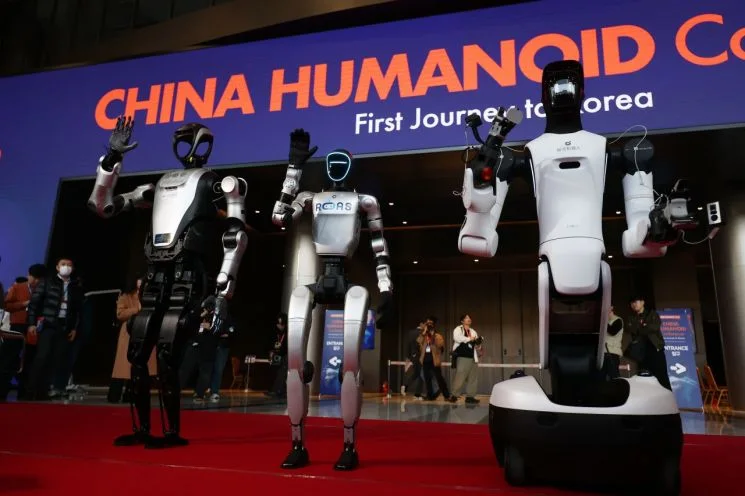
중국은 로봇 학습용 데이터를 사람을 고용해 대규모로 모으고 있습니다. 한국은 양보다 질에 집중하는 전략을 택했습니다. 다만 규모를 어떻게 확보할지가 과제로 꼽힙니다.
중국은 로봇 학습 데이터를 어떻게 모으나
중국은 사람이 직접 일하는 장면을 찍어 로봇에게 가르칩니다. SBS Biz 보도에 따르면 이런 데이터 생산 사업이 중국에서 빠르게 퍼지고 있습니다.
수집원은 머리에 카메라와 센서를 답니다. 그 상태로 재봉이나 수확, 환자 돌봄 같은 일을 합니다. 찍힌 자료는 품질 검사를 거쳐 학습에 쓰입니다.
원격 조작과 1인칭 시연을 함께 씁니다.
징둥(JD.com)은 2026년 3월 장쑤성 쑤첸 수집센터를 넓힌다고 발표했습니다. SBS Biz 보도입니다. 세계 최대 규모를 내걸었고 목표 참여 인원은 수십만 명입니다.
쑤첸 메인 센터는 2025년 10월에 문을 열었고 현재 면적은 약 4천㎡입니다.
아시아경제는 중국이 전국 7곳에서 데이터 팩토리를 운영 중이라고 전했습니다. 중국은 2028년까지 1,000개 업종에 휴머노이드를 들이겠다는 계획도 세웠습니다. 두 수치는 각각 한 매체에서만 확인됩니다.
수집원은 어떤 조건으로 일하나
SBS Biz 보도에 따르면 수집원의 시급은 15위안에서 30위안입니다. 한국 돈으로 약 3,300원에서 6,600원입니다.
근무 기간은 며칠에서 3개월 이상까지 다양합니다. 업체들은 만 18세부터 35세까지를 선호합니다. 품질 검사에서 떨어지면 작업 시간을 인정받지 못한 사례도 있었습니다.
이 조건은 SBS Biz 한 곳의 보도입니다. 업체마다 다를 수 있습니다.
로봇은 왜 사람 동작 데이터가 필요한가
로봇이 물건을 쥐고 옮기는 일을 배우려면 실제 동작 기록이 필요합니다. 아시아경제에 따르면 로봇 데이터는 수집 비용이 영상 데이터보다 훨씬 높습니다. 쌓이는 속도도 느립니다.
안전 문제와 환경의 다양성도 걸림돌입니다. 표준화가 부족하다는 점도 지적됐습니다.
김익재 KIST AI·로봇연구소장은 아시아경제에 이렇게 말했습니다. 시뮬레이션 데이터도 중요하지만 현장의 실제 데이터는 여전히 필수라는 취지입니다.
한국의 강점과 약점은 무엇인가
한국의 강점은 데이터의 정밀도입니다. MTN 머니투데이방송에 따르면 한국은 정부와 기업이 양보다 질에 집중하고 있습니다.
카메라 여러 대로 동시에 촬영합니다. 손의 파지 동작과 접촉하는 힘도 정밀하게 분석합니다.
약점은 규모입니다. MTN은 중국이 가정과 산업현장에 로봇을 배치해 실전 데이터를 쌓는다고 전했습니다.
같은 보도는 업계 전망도 소개했습니다. 2028년경 일부 분야에서 사람 수준의 속도를 내는 로봇이 나온다는 내용입니다. 비용은 연봉 수준까지 내려간다고 봤습니다.
현재 로봇은 작업 속도가 사람보다 느립니다. 가격도 인건비보다 비쌉니다. 이 전망은 MTN 단독 보도라서 업계의 예측으로 봐야 합니다.
MTN은 리얼월드의 RLDX-1이 공개 벤치마크 8종에서 1위를 했다고 보도했습니다. 로보카사 키친 등이 포함됩니다. 이 순위는 MTN 한 곳의 보도이고 평가 방식은 확인되지 않았습니다.
정부와 기업은 어떻게 대응하나
산업부 로봇 PD는 M.AX 얼라이언스 중심으로 세 가지를 논의 중이라고 밝혔습니다. 아시아경제 보도입니다.
- 로봇 학습 데이터 확보
- 핵심 부품 내재화
- 현장 실증 확대
목표는 휴머노이드 3대 강국입니다. 산업부 보도자료 같은 1차 자료는 확인하지 못했습니다.
기업 쪽에서는 로보티즈가 우즈베키스탄 법인과 대형 데이터 팩토리를 추진하고 있습니다. 아시아경제는 미국이 중국에 데이터를 맡기기 어렵다고 전했습니다. 그래서 한국의 고품질 데이터 수요가 있다는 취지입니다.
AI 도구는 데이터 작업을 어떻게 바꾸나
1인칭 영상을 자동으로 정리하는 AI 도구도 나왔습니다. 트웰브랩스가 2026년 10월 7일 ’페가수스 1.6’을 내놓았습니다. AI타임스 보도입니다.
이 모델은 1인칭 영상의 이해와 라벨링을 맡습니다. 라벨링은 영상 속 행동에 이름표를 붙이는 작업입니다. 기능은 다섯 가지입니다.
- 행동 분할과 라벨링
- 상세 캡션 생성
- 품질 평가
- 검색과 큐레이션
- 개인정보 탐지
수작업으로는 원본 영상 1시간에 라벨링이 약 155시간 걸립니다. 트웰브랩스는 이를 자동화한다고 설명했습니다.
이 수치는 회사 설명이며 외부 검증은 확인되지 않았습니다. 현재 미국의 로보틱스 학습 데이터 기업에 적용되고 있습니다.
앞으로 무엇을 지켜봐야 하나
핵심은 한국이 품질 우위를 유지하면서 규모를 얼마나 따라잡느냐입니다. 정부의 데이터 확보 계획이 구체화되는 시점을 지켜볼 만합니다.
자동 라벨링 같은 도구가 비용을 얼마나 낮추는지도 변수입니다. 이번 글의 중국 관련 수치는 대부분 한 매체의 보도에 기댔습니다. 이후 공식 자료가 나오면 달라질 수 있습니다.