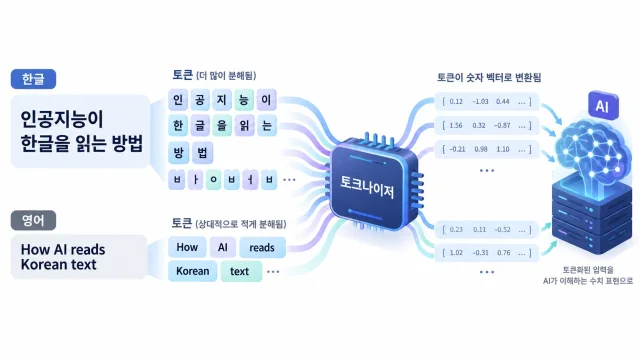
같은 뜻의 문장을 AI에 넣으면 한국어가 영어보다 토큰을 더 많이 씁니다. AI스크롤이 2026년 10월 6일 발표한 실험에서 평균 61% 더 많았습니다. 이 수치는 해당 실험 한 곳의 결과라서 조건이 다르면 달라질 수 있습니다.
토큰은 AI가 글을 계산하는 단위입니다. 토큰이 많으면 비용과 처리 시간이 늘 수 있습니다. 디지털데일리는 이 격차를 AI 주권 문제와 엮어 보도했습니다.
토크나이저란 무엇인가
토크나이저는 글을 AI가 계산할 수 있는 토큰 단위로 쪼개는 도구입니다. 디지털데일리에 따르면 학습 데이터에 자주 나온 글자와 단어 조합은 한 토큰으로 묶입니다.
자주 나오지 않는 조합은 잘게 쪼개집니다. 쪼개진 만큼 토큰 수가 늘어납니다.
한국어는 영어보다 토큰을 얼마나 더 쓰나
디지털데일리가 전한 AI스크롤 실험에서 한국어의 입력 토큰은 영어의 평균 1.61배였습니다. 최신 AI 모델 8종에 같은 뜻의 문장 200개를 넣어 영어 대비 9개 언어를 비교했습니다.
문장은 번역 벤치마크 FLORES-200의 앞 200문장입니다. 고정 토큰은 뺐습니다.
모델마다 차이가 컸습니다. 한국어는 모델별로 영어의 1.27배에서 1.99배까지 나왔습니다.
언어별 배수는 아래와 같습니다. 영어를 1로 놓은 값입니다.
| 언어 | 영어 대비 배수 |
|---|---|
| 중국어 | 1.08 |
| 스페인어 | 1.41 |
| 일본어 | 1.42 |
| 독일어 | 1.46 |
| 프랑스어 | 1.47 |
| 러시아어 | 1.50 |
| 한국어 | 1.61 |
| 아랍어 | 1.63 |
| 힌디어 | 2.27 |
표의 9개 언어(한국어 포함) 평균은 1.54배였습니다. 한국어는 평균보다 조금 높은 편입니다. 기사 안에는 언어 수 표기가 서로 맞지 않는 부분이 있어 표 기준으로 계산했습니다.
앞선 연구도 있습니다. 디지털데일리에 따르면 고려대 연구팀이 2024년에 GPT-4 등 4개 모델을 봤습니다. 한국어가 최대 3배의 토큰을 썼다고 합니다.
LG AI연구원은 2024년 8월 엑사원 3.0 보고서를 냈습니다. 여기서 영어 대비 약 1.7배라고 밝혔습니다.
왜 한국어가 더 많이 쪼개지나
한국어는 조사와 어미가 단어에 붙는 교착어입니다. 어휘집에 이런 형태가 덜 반영되면 한 어절이 여러 토큰으로 나뉩니다.
디지털데일리는 이를 한글 자체의 한계로 보지 않았습니다. 영어 중심의 학습 데이터와 토크나이저 설계에서 생긴 격차라는 해석입니다.
내 구독료와 API 비용은 오르나
개인이 내는 정액 구독료는 당장 달라지지 않습니다. 영향은 토큰 단위로 과금하는 API와 기업용 서비스에 직접 닿습니다.
다만 이 실험은 입력 토큰만 비교했습니다. 실제 청구액은 출력 길이와 모델별 가격에 따라 달라집니다.
토큰이 많으면 연산량이 늘고 한 번에 담을 수 있는 정보가 줄어듭니다. 삼성SDS 인사이트도 한국어는 한 글자가 여러 토큰으로 분리되는 경우가 많다고 설명합니다.
국산 모델은 무엇을 바꾸고 있나
국산 모델 개발사들이 토크나이저 효율을 높이고 있습니다. 아래 수치는 모두 각 회사가 밝힌 것이며 측정 조건이 달라 서로 비교할 수 없습니다.
- LG AI연구원: K-엑사원은 어휘집을 넓히고 SuperBPE를 적용했습니다. 엑사원 4.0보다 한국어 효율이 29% 올랐다고 합니다. 7월 공개한 K-엑사원 2.0의 토크나이저 효율 수치는 공개하지 않았습니다.
- 업스테이지: 솔라 오픈2는 비교한 글로벌 모델의 약 50%에서 80%만 토큰을 썼다고 합니다. 한국어 사무 텍스트 12개 모델 중 효율이 가장 높았다는 설명입니다. 최고 글로벌 모델보다 약 24% 앞섰다고 합니다.
- 카카오: 7월 28일 공개한 카나나2는 경량 모델에 자체 토크나이저를 넣었습니다. 한국어 처리 효율이 30% 이상 좋아졌다고 합니다.
- SK텔레콤: 에이닷엑스 4.0을 자체 시험했습니다. GPT-4o보다 토큰 효율이 약 33% 높았다고 합니다.
반론도 있습니다. 래블업 김준기 CTO는 한국어에 맞추다 영어 성능이 떨어지면 안 된다고 했습니다.
그는 한국어에 특화한 독자 모델이라도 영어 성능을 희생해서는 안 된다는 취지로 말했습니다. 두 언어의 균형이 필요하다는 뜻입니다.
토크나이저가 AI 주권과 무슨 관계인가
디지털데일리는 한국어를 적은 비용으로 처리하는 능력도 AI 주권의 한 축이라고 평가했습니다. 정확히 이해하는 것만으로는 부족하다는 입장입니다.
정부도 평가 기준에 반영했다고 합니다. 독자 AI 파운데이션 모델 사업은 8월 2차 단계평가를 열었습니다. 토크나이저 같은 자체 개발 기술을 독자성 평가에 넣었다는 내용입니다.
이 평가에서 업스테이지와 SK텔레콤, LG AI연구원 3팀이 진출했습니다. 평가 반영 사실은 디지털데일리 한 곳의 보도입니다.
‘모두의 AI’ 사업은 8월 28일 SK텔레콤과 카카오, KT 3곳을 사업자로 선정했습니다. 2027년부터 국민 서비스 비용을 예산으로 지원할 계획입니다. 2027년 예산안에는 2500억원이 잡혀 있습니다.
독자가 할 일
일반 이용자는 당장 할 일이 없습니다. 정액 구독이라면 요금이 그대로이기 때문입니다.
API나 기업용 서비스를 쓴다면 청구서의 토큰 단위를 확인해 볼 만합니다. 모델마다 한국어 토큰 수가 1.27배에서 1.99배까지 갈렸습니다. 사용하는 모델로 같은 문장을 직접 넣어 토큰 수를 재 보면 차이를 알 수 있습니다.